
Quem trabalha com tecnologia conhece bem essa cena. O sistema cai no meio de uma janela crítica, como uma rematrícula, uma Black Friday ou um dia de pagamento. Reúne-se às pressas o time de Desenvolvimento, a equipe de Infraestrutura e os DBAs. E, sem dados precisos e sem uma linguagem comum entre quem entende o sistema e quem precisa decidir sobre ele, começa o jogo de empurra: o desenvolvedor diz que falta máquina, a infraestrutura diz que o banco está lento, o DBA diz que o código está mal escrito. Ninguém está necessariamente errado, e é exatamente por isso que a discussão não converge.
Por que o jogo de empurra acontece
Não é falta de competência técnica. É falta de um ponto de referência comum. Cada equipe enxerga apenas a fatia do sistema que instrumenta: o desenvolvedor vê exceções e tempo de resposta da aplicação; a infraestrutura vê CPU, memória e métricas de VM; o DBA vê contenção de locks (bloqueios) e, em menor grau, deadlocks, além de planos de execução. Sem uma baseline compartilhada que correlacione essas três visões, cada time apresenta um gráfico correto, porém incompleto, e a reunião vira uma disputa sobre qual fatia do elefante é o elefante inteiro.
Esse comportamento também tem uma explicação humana bem conhecida na resposta a incidentes: sob pressão e diante de um sistema fora do ar, a tendência de buscar um culpado é praticamente instintiva. Durante a crise, a prática consolidada é a gestão de incidentes com papéis definidos, sobretudo a figura do Incident Commander, que coordena a investigação e corta o jogo de empurra. Após o incidente, as equipes de SRE combatem a recorrência desse comportamento com o post-mortem sem culpa (blameless postmortem), prática que, segundo o capítulo “Postmortem Culture: Learning from Failure” do livro Site Reliability Engineering, do Google, tem origem em setores como saúde e aviação, onde erros podem ser fatais. A premissa é que todos os envolvidos tinham boas intenções e fizeram o melhor possível com a informação de que dispunham. Como não é possível “consertar” pessoas, o esforço se concentra em corrigir sistemas e processos; e, quando a cultura é de apontar dedos, as pessoas deixam de trazer os problemas à tona por medo de punição.
Essa ideia foi popularizada em 2012 por John Allspaw, então vice-presidente de Operações Técnicas do Etsy, no texto “Blameless PostMortems and a Just Culture”. Allspaw parte do princípio de que falhas são inevitáveis em sistemas complexos e esclarece que “sem culpa” não significa “sem responsabilidade”: os engenheiros cujas ações contribuíram para o incidente relatam em detalhe o que fizeram, o que esperavam e o que presumiram, e assim assumem o compromisso de ajudar a tornar a empresa mais segura e resiliente. É esse equilíbrio entre segurança e responsabilização que ele chama de Just Culture. Para quem quer implantar a prática, há roteiros detalhados da Atlassian, da Rootly e da Pluralsight.
Onde o gargalo geralmente está, e por que ele muda de time
Na prática, a causa raiz de uma lentidão crítica costuma estar em um destes três lugares, raramente isolados: nos limites do servidor de aplicação (o pool de threads, como o maxThreads do Tomcat, ou o pool de conexões com o banco, como o HikariCP, esgotados sob concorrência), nas configurações de instância da nuvem (Azure ou AWS dimensionadas para o tráfego médio, não para o pico) ou em contenção de locks (bloqueios) e, em menor grau, deadlocks de consultas no banco de dados. O problema é que essas três camadas se afetam em cadeia: um lock no banco segura threads da aplicação, que esgotam o pool, o que faz a infraestrutura parecer subdimensionada, quando o gargalo real nunca teve relação com CPU ou memória.
Sem instrumentação que correlacione as três camadas ao mesmo tempo, a war room reativa perde tempo precioso investigando sintomas na ordem errada, enquanto o sistema continua fora do ar e o relógio do negócio continua correndo. Ferramentas de observabilidade com rastreamento distribuído (APM, OpenTelemetry) permitem seguir uma requisição da aplicação até a consulta no banco, corrigindo esse ponto cego.
Da sala de pânico à sala de decisão: o papel da baseline de capacidade
A diferença entre uma guerra de culpa e uma investigação produtiva costuma ser um único artefato: uma baseline de capacidade, isto é, um retrato documentado de como o sistema se comporta sob carga normal e de onde estão seus limites sob carga de pico, obtido com testes de carga e capacidade e conhecido por todos os times antes que a crise aconteça. Com uma baseline, a pergunta deixa de ser “de quem é a culpa” e passa a ser “o que mudou em relação ao que já sabíamos ser normal”, uma pergunta que qualquer uma das três equipes pode ajudar a responder, porque todas partem do mesmo ponto de referência.
O segundo artefato que evita que a mesma crise se repita é uma matriz de débito técnico priorizada: uma lista única, compartilhada pelas três equipes, dos gargalos já conhecidos, ordenados por impacto no negócio e esforço de correção (veja um modelo de matriz de priorização e um guia prático para reduzir débito técnico). Sem essa matriz, cada incidente vira uma investigação do zero; com ela, a war room preventiva já sabe, antes de qualquer alarme tocar, quais componentes têm menos margem e merecem atenção prioritária.
Uma guerra de culpa é sempre, também, uma lacuna executiva
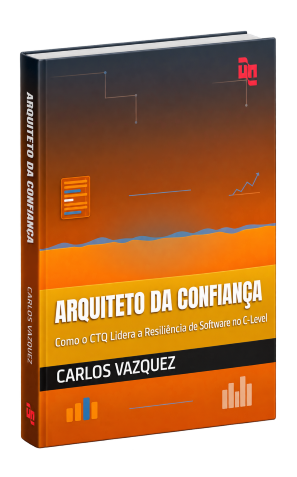
A problemática central da paralisia operacional reflete a tese estruturante desenvolvida por Carlos Eduardo Vazquez em seu livro Arquiteto da Confiança: Como o CTO Lidera a Resiliência de Software no C-Level. A obra demonstra que esse jogo de empurra decorre da histórica lacuna de comunicação entre a “sala de máquinas” (onde engenheiros discutem comportamento de filas e saturação de CPU) e a “sala de reuniões” (onde a diretoria discute risco reputacional e receita). Sem um ponto de referência compartilhado, a liderança fica impedida de enxergar e governar o risco técnico antes do colapso.
Ao propor a transição da reunião de pânico para uma War Room Preventiva, fundamentada na certificação da Baseline de Capacidade Nominal e no cálculo do ROI da performance, o livro fornece a sustentação teórica e metodológica exata para as práticas discutidas aqui. Essa abordagem capacita executivos e CTOs a traduzirem as métricas das equipes técnicas em decisões claras, transformando a resiliência de sistemas em um ativo estratégico de governança, proteção de receita e continuidade de negócio.
Agradecimento técnico: Este artigo contou com a valiosa revisão e as contribuições de Paulo Panno, da equipe do Performance Spot. Suas intervenções foram decisivas para elevar o rigor técnico do conteúdo, incluindo:
- A distinção precisa entre o pool de threads do servidor de aplicação e o pool de conexões com o banco de dados;
- A diferenciação entre a contenção de locks (causa real de lentidão e enfileiramento) e a resolução automática de deadlocks;
- A expansão da baseline de capacidade para contemplar limites sob carga de pico obtidos via testes de capacidade;
- A inclusão de conceitos de observabilidade e rastreamento distribuído (APM e OpenTelemetry);
- A clareza sobre o papel do Incident Commander durante a crise, complementando o post-mortem sem culpa no pós-crise.
Referências
FATTO Consultoria e Sistemas
© 2026 FATTO Consultoria e Sistemas. Todos os direitos reservados.