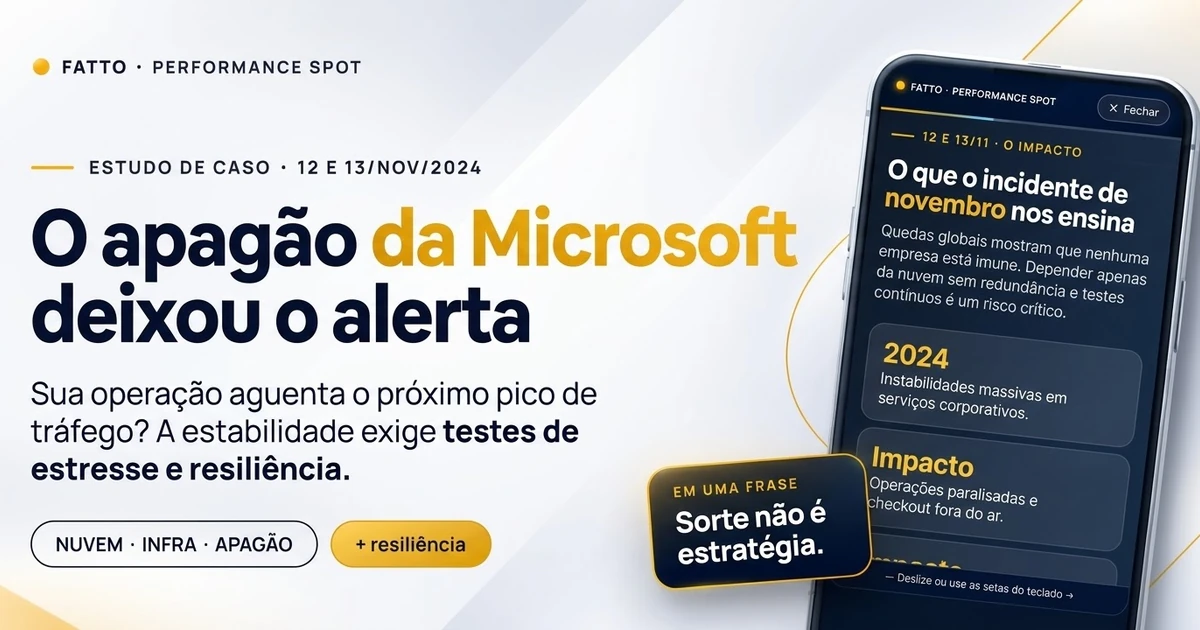
Análise de incidente · Microsoft, 12 e 13/11/2026
O apagão da Microsoft de 12 e 13/11: o que ele ensina sobre resiliência e como testar o seu sistema antes
Durante cerca de 18 horas, Outlook, Teams e Copilot ficaram instáveis em dezenas de países. A causa ainda é preliminar, mas os relatos já mostram padrões conhecidos de falha em cascata: verificações de saúde que derrubam servidores, mudança de configuração como gatilho e recuperação que não se sustenta. A pergunta útil para a sua empresa não é "por que a Microsoft caiu", e sim "o meu sistema sabe falhar e se recuperar?".
Resumo executivo
Não é sobre a Microsoft. É sobre o que acontece quando uma peça falha no seu sistema
O incidente começou na quinta-feira (12/11) e se estendeu pela sexta (13/11). A Microsoft descartou ataque cibernético e atribuiu o problema, até agora, a uma mudança de rede. Os detalhes técnicos ainda serão publicados em relatório.
Os padrões que já aparecem nos relatos (cascata, verificação de saúde, recuperação instável e dependência de terceiros) são testáveis em qualquer sistema. É esse o trabalho do Performance Spot, da FATTO: descobrir, antes do incidente, onde o seu sistema quebra e quanto tempo leva para voltar.
Cerca de 18 horas de instabilidade
Outlook, Teams, Copilot e outros serviços do Microsoft 365, em mais de 70 países.
Preliminar
Sem ataque. Relatos apontam verificações de saúde falhando e uma mudança recente de configuração de rede.
Padrões repetíveis
Cascata, recuperação instável e dependência de terceiros acontecem em sistemas de qualquer porte.
Testar antes
Estresse com perda de nós, teste de recuperação e baseline a cada mudança de infraestrutura.
A pergunta mudou na sexta-feira
Na quinta, a pergunta era "por que caiu?". Na sexta, depois de horas de recuperação gradual e de relatos de servidores recuperados voltando a falhar, passou a ser: "por que está demorando tanto para voltar?" A resposta, em termos de engenharia, está na seção 3.
Nota sobre a apuração
Este texto foi escrito em 13/11/2026, com o incidente ainda em recuperação. A Microsoft prometeu um relatório completo após a revisão, e a causa raiz pode mudar. Tratamos os relatos como hipóteses de engenharia e não como veredito. Atualizaremos este artigo quando o relatório sair.
1. O que aconteceu nos dias 12 e 13 de novembro?
Os problemas começaram na tarde de quinta-feira (12/11), e em cerca de uma hora a plataforma Downdetector já registrava relatos de 74 países, segundo a Al Jazeera. Foram afetados Exchange Online (Outlook), Teams, Copilot, SharePoint, OneDrive, Intune e Defender. Em reportagem do TechCrunch, a falha também impediu administradores de acessar os painéis do Intune.
| Quando | O que foi relatado | Fonte |
|---|---|---|
| Qui 12/11, tarde | Usuários perdem acesso ao Outlook. Em cerca de uma hora, relatos em 74 países. | Al Jazeera |
| Qui 12/11 | A Microsoft cita carga acima do normal em parte da infraestrutura, e depois diz que servidores falham em verificações automáticas de saúde e saem do ar. | CNBC; SecurityWeek |
| Qui 12/11 | Todas as implantações e mudanças de configuração são pausadas. | iMasters |
| Qui 12/11, noite | A empresa diz que um processo que estabelece conexões seguras ficou sobrecarregado e reverte uma mudança recente de configuração de rede. | SecurityWeek |
| Qui 12/11 a sex 13/11 | Recuperação gradual, com relatos de servidores recuperados voltando a falhar. | Tek Notícias |
| Sex 13/11 | Microsoft pede desculpas, atribui o problema a mudanças na rede e promete relatório. Duração estimada: cerca de 18 horas. | Antihype (medição da Kentik); TecStudio |
Os horários variam entre as fontes, e a recuperação foi gradual por região. Consulte o relatório oficial da Microsoft quando for publicado.
2. O que a causa preliminar sugere?
A Microsoft separou duas coisas: o problema raiz foram servidores saindo do ar, e não um pico de tráfego por excesso de acessos. Segundo o iMasters, a rede estava com carga elevada em várias regiões, o que provavelmente contribuiu para os erros de conectividade. Três elementos chamam a atenção do ponto de vista de engenharia:
Quem vigia também falha
Servidores falharam em verificações automáticas e ficaram indisponíveis. A proteção virou parte do problema.
Mudança de configuração
A Microsoft reverteu uma alteração recente de rede que coincidiu com o início da queda.
Voltar não é simples
Servidores restaurados voltaram a falhar, e a recuperação foi gradual ao longo de horas.
O que isso não prova: não sabemos se um teste de carga ou de estresse teria evitado esse incidente específico, e não afirmamos isso. O valor da análise está em reconhecer padrões que se repetem em sistemas de qualquer tamanho, e que podem ser verificados no seu.
3. Cinco lições que você pode testar no seu sistema
Cada lição abaixo corresponde a uma pergunta que um teste de performance consegue responder.
Verificações de saúde sob estresse
O que acontece quando as verificações falham sob pressão e retiram servidores do pool em massa? O teste de estresse deve incluir esse cenário.Falha parcial que vira cascata
Se parte dos nós cai, os restantes aguentam a carga extra ou caem em seguida? Teste de estresse com perda de nós mede capacidade residual.Recuperação sob carga
Quando os servidores voltam, a reintrodução é gradual, ou uma enxurrada de retentativas os derruba de novo? É preciso testar warm-up, retry storm e o tempo de recuperação (MTTR).Mudança de configuração como gatilho
Cada alteração de rede, capacidade ou configuração passa por um baseline de performance e tem rollback testado? Baselines contínuas no pipeline respondem a isso.Dependência de terceiros e visibilidade
Seu negócio depende de e-mail, autenticação ou nuvem de terceiros. Há degradação graciosa e contingência? E o seu monitoramento depende da mesma infraestrutura que pode falhar?
| Lição | Teste que responde | Evidência esperada |
|---|---|---|
| Verificação de saúde | Estresse com verificações falhando. | Comportamento do pool e dos balanceadores sob pressão. |
| Cascata | Estresse com perda de nós. | Capacidade residual e ponto de saturação. |
| Recuperação | Teste de recuperação e de pico após restauração. | MTTR e estabilidade na reintrodução. |
| Mudança | Baseline de performance a cada alteração. | Regressão detectada antes de produção. |
| Terceiros | Simulação de lentidão e indisponibilidade de dependências. | Timeout, contingência e degradação graciosa. |
Esses conceitos já foram detalhados no blog: veja o guia técnico de teste de carga, estresse e diagnóstico de performance e por que a war room vira jogo de empurra entre dev, infra e DBA.
4. Qual é o nexo com o Performance Spot?
O Performance Spot, da FATTO, é um serviço de diagnóstico e engenharia de performance. Ele transforma essas lições em evidências para o seu sistema: onde ele satura, como falha, quanto tempo leva para se recuperar e o que corrigir primeiro.
Precisão métrica
Engenharia de software e análise de pontos de função aplicadas ao dimensionamento e à leitura dos resultados.
Resiliência recorrente
Carga, estresse e análise de gargalos repetidos a cada mudança relevante.
Laudo acionável
Análise de gargalos com prioridades de correção e apoio consultivo para validar a melhoria.
Quer saber como o seu sistema se comporta?
Faça uma avaliação inicial em performance.fattocs.com.br/teste-seu-site e conheça o Performance Spot.
5. Seis perguntas que a diretoria deveria fazer esta semana
Sobre falha
- O que acontece se 30% dos nós do sistema crítico saírem do ar?
- Nossas verificações de saúde podem derrubar o que deveriam proteger?
Sobre recuperação
- Qual é o nosso MTTR medido, e não estimado?
- A reintrodução de servidores é gradual ou em bloco?
Sobre mudança
- Alguma mudança de configuração vai a produção sem baseline de performance?
- O rollback já foi testado sob carga?
Sobre dependências
- Se e-mail, autenticação ou nuvem de terceiros cair, o que continua funcionando?
- O nosso monitoramento sobrevive à mesma falha?
6. Perguntas frequentes sobre o apagão da Microsoft e resiliência
O que aconteceu com a Microsoft em 12 e 13 de novembro de 2026?
Outlook, Teams, Copilot e outros serviços do Microsoft 365 ficaram instáveis por cerca de 18 horas, em mais de 70 países. A Microsoft informou que não houve ataque cibernético e atribuiu o problema a uma mudança de rede. A causa detalhada ainda será publicada em relatório.
Foi um ataque hacker?
Segundo a Microsoft, não há indício de atividade maliciosa. Especialistas ouvidos pela imprensa brasileira apontam como hipótese uma falha de configuração de rede.
Um teste de carga teria evitado o apagão?
Não é possível afirmar. A causa ainda é preliminar, e ninguém de fora tem acesso à arquitetura da Microsoft. O que o episódio mostra são padrões que se repetem e que testes de estresse, de recuperação e de baseline conseguem verificar nos seus sistemas.
O que é falha em cascata?
É quando a falha de uma parte do sistema sobrecarrega as demais, que também falham em sequência. O raio de impacto (blast radius) mostra quanto do sistema é afetado quando algo falha.
O que é MTTR e por que testá-lo?
MTTR é o tempo médio para restaurar o serviço após uma falha. Testá-lo mostra se a recuperação é rápida e estável, ou se os componentes restaurados voltam a falhar sob carga.
Como se preparar para a falha de um fornecedor de nuvem ou SaaS?
Mapeie as dependências críticas, defina o que deve continuar funcionando sem elas, teste timeouts e degradação graciosa, e mantenha o monitoramento fora do mesmo domínio de falha.
O Performance Spot pode ajudar a minha empresa?
Sim, se você precisa saber onde o seu sistema satura, como ele se comporta com perda de componentes e quanto tempo leva para se recuperar. O serviço entrega diagnóstico, análise de gargalos e um laudo acionável.
Referências e leituras recomendadas
Dados consultados em 13/11/2026, com o incidente em recuperação. Informações sujeitas a revisão quando a Microsoft publicar o relatório completo.
- SecurityWeek: Microsoft 365 outage disrupts Outlook, Exchange Online and Teams.
- Al Jazeera: Microsoft hit by global outages, what happened and why.
- TechCrunch: Microsoft's latest email outage turned into a full blown global cloud crisis.
- CNBC: Outlook outage continues as Microsoft flags encouraging recovery signals.
- iMasters: falha na nuvem da Microsoft tira Outlook, Teams e SharePoint do ar por horas.
- Antihype: Microsoft culpa mudança na própria rede pelas 18 horas de Outlook fora do ar.
- Tek Notícias: servidores recuperados voltam a falhar.
- TecStudio: Microsoft diz que falha no 365 veio de mudança na rede.
- Guia técnico: teste de carga, estresse e diagnóstico de performance (FATTO).
Próximo passo
Descubra como o seu sistema falha e se recupera antes que a produção mostre
O Performance Spot, da FATTO, entrega diagnóstico de carga e de estresse, análise de gargalos e um laudo acionável. Faça uma avaliação inicial e conheça o serviço.
Análise baseada em relatos públicos de 12 e 13/11/2026. Não substitui o relatório oficial do fornecedor.
FATTO Consultoria e Sistemas
© 2026 FATTO Consultoria e Sistemas. Todos os direitos reservados.